Qui a formulé ce cas ? Trois réflexes pour décider avec un assistant IA
Une étude publiée fin octobre 2026 montre que des experts suivent l'option assignée à leur assistant IA sur des décisions sans bonne réponse, et s'en rendent rarement compte. Ce que cela peut signifier pour vos formulations de cas, et trois gestes de quelques minutes pour garder ces décisions ouvertes.
Source analysée
Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls (Herdağdelen, Joren et Tamkin, Anthropic, 2026)Partons d’un cas d’usage fictif mais concret, pour illustrer comment les enseignements de l’étude présentée ici pourraient s’appliquer à la pratique d’un psychologue.
Mardi, 19h, entre deux séances. Une psychologue TCC prépare la formulation de cas d’une patiente de 34 ans : anxiété généralisée, évitement des appels et des sorties, ruminations le soir. Elle décrit la situation à son assistant IA, sans nom ni détail identifiant, et lui demande d’organiser l’analyse fonctionnelle.
La réponse de l’assistant est claire et bien construite. Il propose de cibler d’abord l’évitement, avec de bons arguments : l’évitement entretient l’anxiété, l’exposition graduée permet de le traiter, et les progrès de l’exposition se mesurent facilement (appels passés, sorties faites). La psychologue trouve l’argument juste et retient cette option.
Commencer par les ruminations aurait aussi été défendable. Aucune des deux options n’est une erreur. La question est ailleurs : cette décision, qui l’a prise ? Une étude publiée fin octobre 2026 permet de poser cette question avec des chiffres.
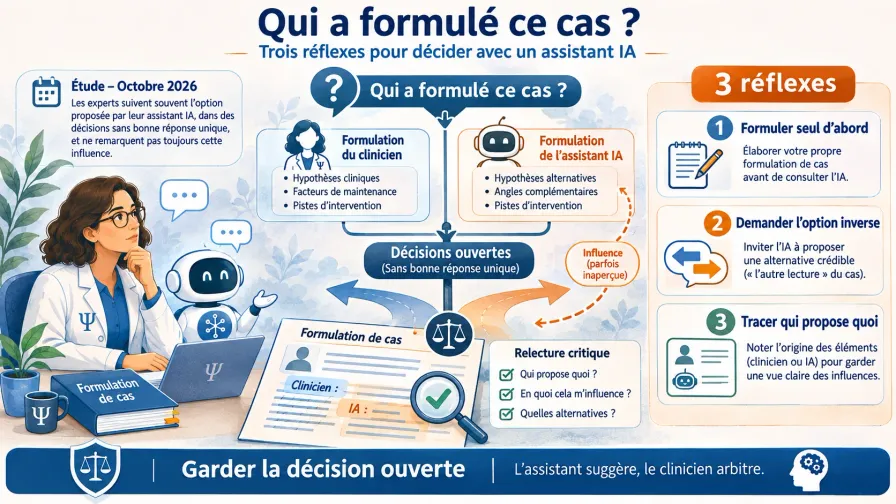
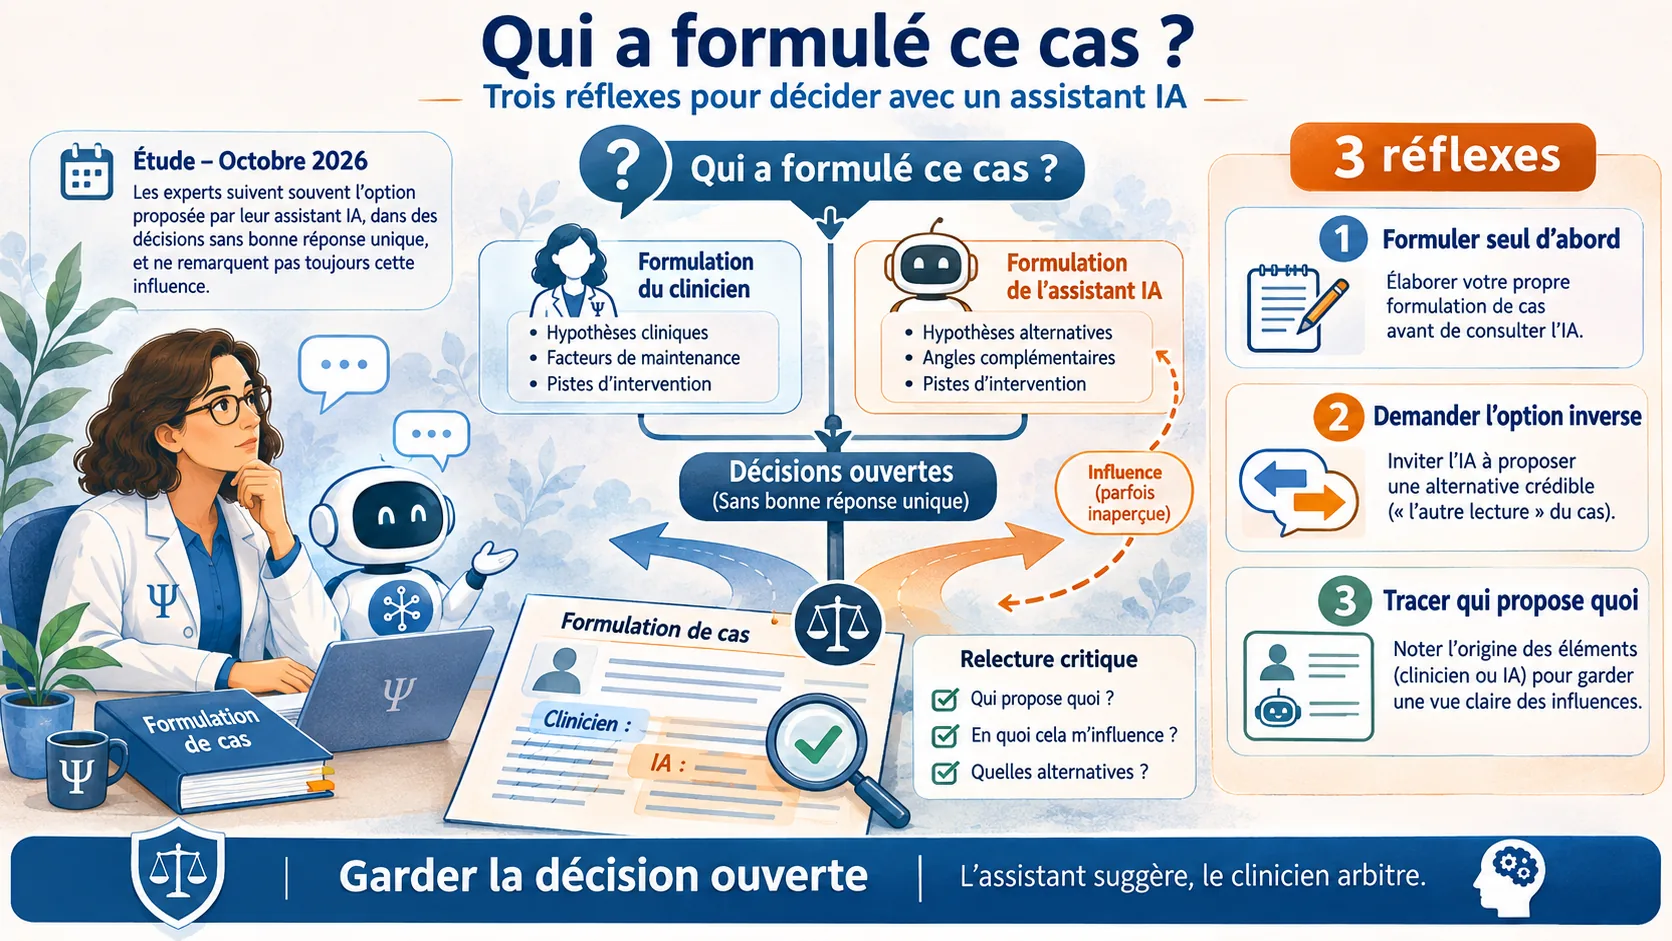
Ce que l’étude a mesuré
Les experts suivent l’option assignée à l’IA dans 86 % des cas.
Amaç Herdağdelen, Hailey Joren et Alex Tamkin, chercheurs chez Anthropic, l’entreprise qui développe l’assistant Claude, ont recruté 50 praticiens de l’analyse de données1. Pendant environ une heure, chacun a travaillé avec un agent IA de programmation, c’est-à-dire un assistant capable d’exécuter lui-même des tâches, ici écrire et lancer du code d’analyse, sur un cas fictif : une coopérative agricole devait-elle étendre ou arrêter un programme de conseil à ses exploitants ?
Il fallait trancher quatre décisions de méthode, puis la recommandation finale, chacune défendable dans les deux sens. Par exemple : faut-il rapporter la production à la surface cultivée ou aux coûts d’exploitation ? Pour chaque décision, un tirage au sort fixait l’option vers laquelle l’agent pencherait. Les participants ne le savaient pas. L’agent devait défendre honnêtement l’option qui lui était assignée, sans cacher de données ni avancer d’argument que les données ne soutiennent pas.
Résultat : sur les quatre décisions de méthode, les choix des participants suivent l’option assignée à l’IA dans 86 % des cas, quand le hasard seul en donnerait 50 %. C’est l’hypothèse principale de l’étude, inscrite dans un plan d’analyse déposé publiquement.
Le tirage au sort permet de mesurer l’influence de l’agent sans avoir à décider qui avait raison. Deux précisions dès maintenant : les participants ne sont pas des cliniciens, et l’agent avait reçu la consigne d’exprimer l’option qui lui était assignée.
Quand il n’y a pas d’erreur à repérer
Vérifier ne suffit plus quand aucune option n’est fausse.
La plupart des travaux sur la confiance envers les outils automatisés portent sur des tâches qui ont une bonne réponse : une lésion est présente ou non, une alerte est fondée ou non. Ces travaux étudient le biais d'automatisation, la tendance à suivre la machine même quand elle se trompe. La parade y est connue : vérifier.
Dans l’étude, il n’y a rien à vérifier. Aucune option n’est fausse, et le travail rendu paraît solide quel que soit le choix. Le retour d’expérience ne tranchera pas non plus plus tard. Les auteurs rapprochent ces situations de ce que le psychologue Robin Hogarth a appelé, dès 2001, des environnements d’apprentissage « retors » : dans ces environnements, l’expérience dit mal si l’on a eu raison, et peut même enseigner faux2.
C’est ici que l’étude rejoint la clinique, sous forme d’hypothèse et non de résultat. Une formulation de cas enchaîne des décisions de ce type : quelle cible traiter en premier, quelle hypothèse de maintien retenir, quel critère de progrès suivre (un score au GAD-7 ou un objectif de la vie quotidienne). Chacune de ces décisions se défend dans plusieurs sens, et l’évolution du patient dira rarement laquelle était la meilleure.
Ce que les participants ont dit de leurs choix
Les participants sous-estiment l’influence de l’IA.
Après la tâche, les participants ont répondu à un questionnaire. Ils se souvenaient bien de leurs choix : 85 % de réponses exactes. 52 % estimaient que la recommandation finale venait davantage d’eux que de l’agent.
Le questionnaire leur demandait ensuite de justifier chaque choix. 77 % ont repris au moins un argument donné par l’agent pendant la séance de travail, parfois presque mot pour mot. 15 % seulement ont mentionné l’agent dans l’une de leurs réponses. Et les participants qui avaient suivi l’agent sur les quatre décisions se disaient aussi sûrs de leur recommandation que les autres : 71 contre 73, sur une échelle de 0 à 100.
Ces mesures sont exploratoires, mais elles vont dans le même sens : ni le sentiment d’avoir décidé ni l’assurance ressentie ne signalent l’influence de l’outil.
Il n’y a là rien de honteux. Nous oublions souvent d’où vient une idée, qu’elle sorte d’un manuel, d’une supervision ou d’une conversation entre collègues. La question posée aux participants demandait des raisons, pas des sources, et 46 % d’entre eux pensaient d’ailleurs que l’étude portait sur la dépendance à l’IA. L’outil n’invente sans doute pas ce mécanisme ordinaire de l’oubli de la source. On peut se demander s’il ne lui offre pas beaucoup plus d’occasions.
Deux mécanismes : un seul côté plaidé, et l’outil qui parle d’abord
L’influence passe par l’argumentation d’une seule option et par l’ordre de parole.
L’agent ne mentait pas. En relisant les échanges, les auteurs concluent que l’influence de l’agent « ne passait pas par le fait d’induire en erreur ou de cacher des conséquences, mais par le fait de ne plaider que pour une seule option » (p. 13, notre traduction). L’agent expliquait souvent ce qu’un autre choix changerait au résultat. Il expliquait rarement pourquoi un expert compétent pourrait préférer cet autre choix, et sous quelles hypothèses. Les auteurs appellent cette explication manquante le « second niveau de contraste ».
Le second mécanisme tient à l’ordre de parole. Dans 77 % des décisions, l’agent a exprimé une option avant le participant. Souvent, le participant n’avait pas encore d’avis à défendre. Or nos préférences se construisent en partie au moment où nous décidons, rappellent les auteurs en s’appuyant sur les travaux du psychologue Paul Slovic (1995)3. Quand l’outil tranche d’emblée, l’outil tranche aussi à la place de ce travail de construction.
Avoir déjà un avis ne suffit pas toujours. Quand un participant avait pris position et que l’agent soutenait ensuite l’option inverse, le participant changeait d’avis dans 60 % de ces cas, soit 53 points de plus que lorsque l’agent allait dans son sens. Ce chiffre porte sur un sous-groupe que les participants ont formé eux-mêmes en s’exprimant les premiers : il se lit avec prudence. Les biais de cadrage et d’ancrage, familiers en TCC, éclairent une partie de ces observations, sans les épuiser.
Ni l’expérience ni la méfiance ne protègent
Aucun profil de praticien n’échappe à l’effet.
On pourrait penser que l’expérience, ou une saine méfiance envers l’IA, met à l’abri.
Les auteurs ont testé dix caractéristiques des participants, dont les années de pratique, le niveau d’expertise, la confiance envers l’IA et le goût pour l’effort intellectuel. Aucune de ces caractéristiques ne réduit l’effet de façon robuste, et la confiance moyenne envers l’IA était plutôt basse. La littérature sur le biais d’automatisation faisait déjà ce constat : l’expertise ne protège pas (Parasuraman et Manzey, 2010)4. L’analyse est exploratoire et porte sur 50 personnes ; elle ne montre pas que tout le monde est influencé de la même façon. Elle suggère plutôt qu’il n’existe pas de profil à risque à éviter : la question concerne tous les utilisateurs.
Trois réflexes pour la prochaine formulation de cas
Six minutes pour garder les décisions cliniques ouvertes.
Transposée avec prudence, l’étude suggère ceci : sur les décisions cliniques sans bonne réponse, un assistant qui n’argumente qu’une option peut orienter la formulation de cas sans que nous le remarquions. Trois gestes de quelques minutes permettent de garder ces décisions ouvertes. Les auteurs les proposent comme pistes ; leur étude ne les a pas testés.
Ces gestes s’ajoutent aux précautions de base sans les remplacer : ne confier à l’outil qu’une description sans donnée identifiante, comme dans notre vignette, dans le respect du secret professionnel et du RGPD, et garder à l’esprit que la formulation de cas reste un acte dont vous portez la responsabilité clinique.
Écrire son hypothèse avant d’ouvrir l’outil · 2 minutes
Trois lignes : la cible que vous traiteriez en premier, l’hypothèse de maintien qui vous paraît centrale, le critère de progrès que vous suivriez. Pour notre patiente, cela pourrait donner : « ruminations d’abord, entretenues par l’intolérance à l’incertitude ; suivi par un agenda des inquiétudes ». Dans d’autres études, sur des tâches qui ont une bonne réponse, demander sa propre décision avant de montrer la recommandation a réduit la dépendance aux recommandations erronées (Buçinca, Malaya et Gajos, 2021)5. Ce geste ne suffit pas seul : on l’a vu, un avis déjà formé cède souvent quand l’outil le contredit.
Demander l’autre côté · 1 minute
La démarche est familière : le diagnostic différentiel sert justement à ne pas s’arrêter à la première hypothèse et à limiter les biais de confirmation et d’ancrage. Il s’agit ici de l’étendre à des décisions plus ouvertes, comme le choix de la cible ou de l’hypothèse de maintien, où aucune grille de critères ne départage les options. « Es-tu sûr ? » appelle un oui ou un non, pas un argument. Demandez plutôt à l’outil de plaider l’option qu’il n’a pas retenue :
Quelle autre option un clinicien compétent pourrait-il retenir ici ? Sous quelles hypothèses, et pour quelles valeurs, serait-elle la meilleure ? Ne tranche pas : présente les deux lectures à égalité.
Pour notre patiente, la réponse montrera pourquoi commencer par les ruminations se défend aussi, et ce que ce choix suppose. Vous choisissez alors entre deux lectures argumentées.
Repérer les décisions intermédiaires · 3 minutes
Dans l’étude, l’agent influençait peu la recommandation finale de façon directe : l’effet sur cette recommandation était faible et non significatif. Pourtant, les seules options tirées au sort sur les quatre décisions de méthode permettaient de prédire 82 % des recommandations d’étendre ou d’arrêter le programme, parmi les participants qui n’ont pas proposé de le prolonger d’un an, contre 61 % en pariant toujours sur la recommandation la plus fréquente (analyse exploratoire). L’orientation se joue en amont. Avant de valider une formulation de cas préparée avec l’outil, listez les décisions intermédiaires de cette formulation : quel matériel a été retenu ou laissé de côté, quelle cible, quelle mesure. Pour chaque décision, demandez-vous qui l’a proposée.
Garder ce que l’outil apporte
Moins d’erreurs et plus de rapidité : le gain est réel.
Faut-il alors se passer de l’outil ? L’étude invite plutôt à regarder ce que l’outil apporte. Avec l’agent, les erreurs de méthode graves passent de 55 % à 6 % des analyses, et le temps médian de 90 à 65 minutes. Malgré cette différence flagrante, l’expérience ne permet pas de l’attribuer avec certitude à l’agent : les 11 participants sans IA avaient choisi eux-mêmes de s’en passer, et ils étaient moins nombreux à se dire experts.
Les auteurs distinguent deux marges de liberté. La première laisse place à l’arbitraire, voire à l’erreur, que l’outil peut utilement réduire. La seconde est la marge de jugement, celle pour laquelle on fait appel à un professionnel. Confier une partie d’une tâche à un outil, ce que la psychologie cognitive appelle le délestage cognitif, est souvent adaptatif. Mais quand la tâche contient des choix sans bonne réponse, notent les auteurs, le travail délégué « passe de l’exécution au jugement » (p. 4, notre traduction). Leur conclusion donne un cap : « avec les bons outils, ce partage peut être quelque chose que nous choisissons, plutôt que quelque chose vers quoi nous dérivons » (p. 15, notre traduction).
Ce que l’étude ne dit pas
Des limites à garder en tête avant toute transposition.
- Pas des cliniciens. Les participants étaient des praticiens de l’analyse de données. La tâche, fictive, durait une heure, dans un domaine nouveau pour eux, et l’échantillon était jeune et très majoritairement masculin.
- Une consigne cachée, suivie même contre la préférence de l’agent. L’agent recevait une instruction secrète (un « prompt système », invisible pour les participants) qui lui demandait de défendre l’option tirée au sort. Sans cette instruction, le même agent a une préférence par défaut : laissé à lui-même, il fait les mêmes cinq choix dans 91 % des simulations des auteurs. Quand l’option tirée au sort allait contre cette préférence par défaut, l’agent a malgré tout défendu l’option assignée dans 87 % des simulations. Il suivait donc bien la consigne des chercheurs, et non sa propre préférence.
- Un penchant amplifié. Sans consigne, l’agent ne défendait spontanément sa préférence par défaut contre le choix de l’analyste que dans 41 % des cas. L’effet mesuré est donc celui d’un agent plus insistant qu’un assistant ordinaire.
- Pas de comparaison avec un humain. L’étude ne compare pas l’agent à un collègue qui parlerait le premier ; on ne sait donc pas ce qui revient en propre à l’IA.
- Une étude non encore évaluée par des pairs. Elle émane d’Anthropic et elle est pré-enregistrée.
Une question à garder
Reprenez votre dernière formulation de cas préparée avec un outil. Quelle décision auriez-vous prise autrement sans lui ? Et le sauriez-vous ?
Une question plus large reste ouverte, que nous traiterons dans un prochain article : si nous consultons tous les mêmes outils, nos formulations de cas vont-elles finir par se ressembler ?
Pour aller plus loin
Fiche concept : le biais d’automatisation
Le cadre classique, celui des tâches qui ont une bonne réponse, que l’étude dépasse.
Fiche concept : la sycophancy des LLM
Le mouvement inverse : quand c’est le modèle qui s’aligne sur l’utilisateur. Voir aussi notre article IA sycophantes : resituer le débat.
Le modèle d’Anthropic utilisé dans l’étude : fonctionnement, usages documentés en santé mentale, analyse critique pour les cliniciens.
Aucune donnée de patient n’a été utilisée pour la vignette d’ouverture.
Références
-
Herdağdelen, A., Joren, H. et Tamkin, A. (2026, 27 octobre). Who’s Aligned to Whom? How AI Agents Shape Experts’ Research Judgment Calls. Anthropic Research. anthropic.com/research/agents-judgment-calls — pré-enregistrement : osf.io/t3q59. ↩
-
Hogarth, R. M. (2001). Educating Intuition. University of Chicago Press ; Hogarth, R. M., Lejarraga, T. et Soyer, E. (2015). The Two Settings of Kind and Wicked Learning Environments. Current Directions in Psychological Science, 24(5). La traduction « loyal / retors » de kind / wicked est la nôtre. ↩
-
Slovic, P. (1995). The construction of preference. American Psychologist, 50(5), 364-371. ↩
-
Parasuraman, R. et Manzey, D. H. (2010). Complacency and Bias in Human Use of Automation: An Attentional Integration. Human Factors, 52(3), 381-410. ↩
-
Buçinca, Z., Malaya, M. B. et Gajos, K. Z. (2021). To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI in AI-assisted Decision-making. Proceedings of the ACM on Human-Computer Interaction, 5. doi:10.1145/3449287 ↩
Mots-clés